导语
你大概有过这种体验:同样一句提示词,今天生成的图惊艳到想截图保存,明天再点一次,手指画成了六根。文字也一样——这一版文案通顺自然,重生成一版就开始胡言乱语。
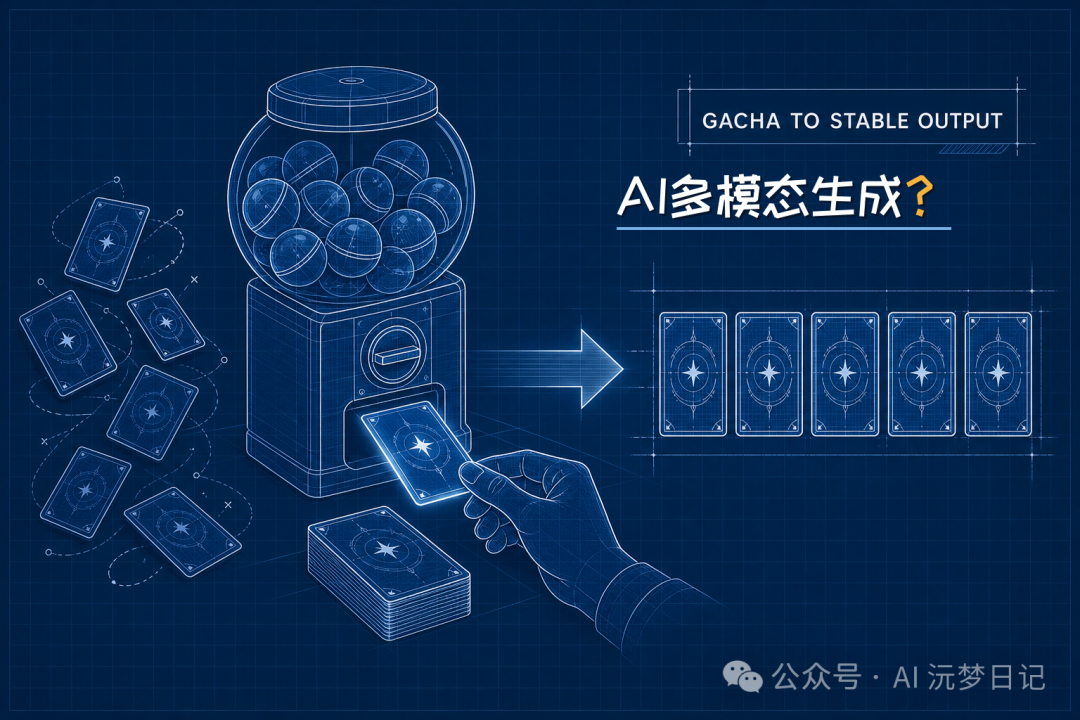
我们把这种现象叫抽卡。生成式 AI 本质上就是台抽卡机:你投进一段提示词,它还你一个带运气成分的结果。出货了皆大欢喜,没出货……那就再来一发。
前两篇我们聊了多模态生成的概念和工具。这一篇想回答一个更现实的问题:工具都到手了,怎么让 AI 稳定地产出你满意的图文?
答案不是“找到一条万能提示词一次成型”——那是幻想。答案是承认抽卡的存在,然后把抽卡这件事做得更聪明。
一、把生成看成抽卡,问题一下就清楚了
一旦你接受“生成 = 抽卡”,模糊的焦虑就变成了三个能动手解决的问题:
- 怎么让 每一抽更可能出货 ?
- 怎么 判断这一抽到底出没出货 ?
- 没出货怎么办 ?
这三个问题分别对应三件事:把需求讲清楚(结构化提示词)、定义什么叫达标(Eval)、不达标就修复(迭代)。它们连起来,就是一条闭环:
结构化提示词 → 生成(抽卡)→ Eval 判定 → 达标留下/不达标修复重来 → ……
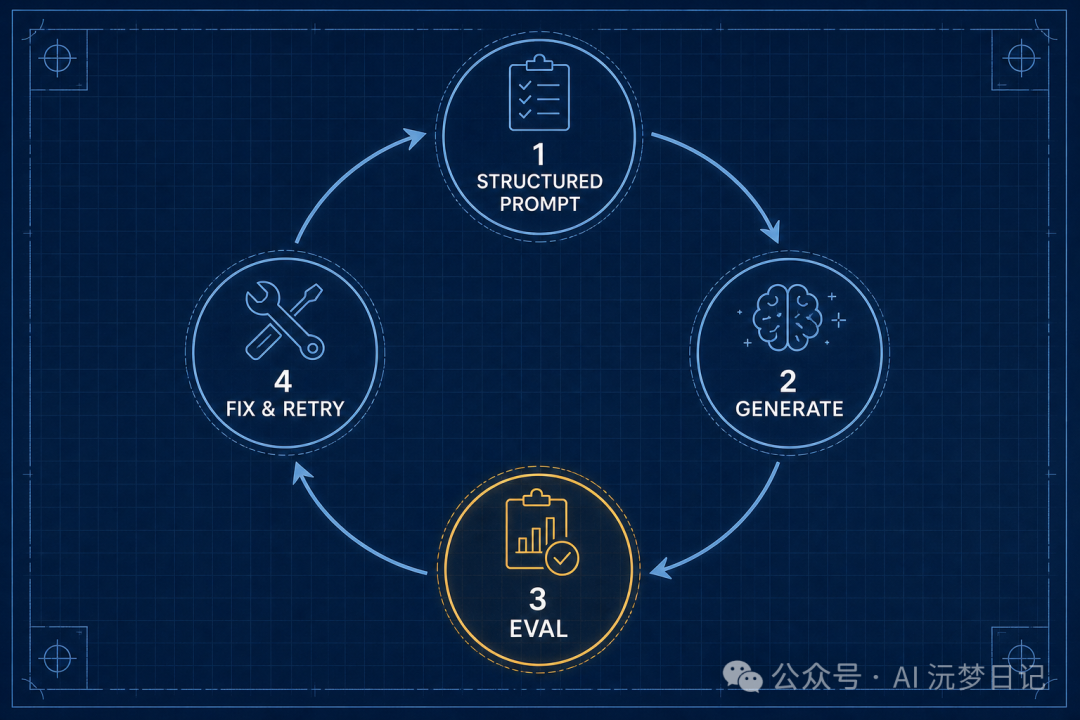
其实大多数人天天在跑这条环:写提示词、看结果、不满意就改了重画。只不过是凭感觉在跑。这篇想说的,就是怎么把这条凭感觉的环,升级成有标准、可复现、还不累人的工作流。
下面挨个拆。
二、提高出货率:把“我想要什么”讲成结构
为什么“画一只猫”出货率低?因为你把九成的决定权交给了运气。模型得替你猜:什么品种、什么姿势、什么背景、什么画风、要不要文字……每一项它都随机发挥,凑齐你心里那张图的概率自然低。
结构化提示词,本质是把你脑子里默认的要求显性地写出来,少给运气发挥的空间。一个朴素但好用的结构:
- 主体 :橘猫,幼猫,圆脸
- 场景/动作 :趴在窗台打盹,窗外下着雨
- 风格 :扁平插画,暖色调
- 约束 :画面里不要出现文字
- 输出 :横版,左侧留白给标题
提示词能抠到多细?去年模型能力还没现在这么强,我做绘本时为了让同一个角色每页都连贯,提示词抠得极细——细到连衣袖的长度都要写明。现在模型聪明多了,未必需要这么钻,但道理没变:你越想要稳定,就越得把“默认在你脑子里”的东西,一条条搬到提示词里。
当然,上面这个结构只是个最朴素的示范,谈不上多好——真正讲究的提示词还有大量门道:负向提示词、权重控制、参考图、风格锚定……而且每个生图工具的脾气还不一样。但别被具体写法绕进去,这一节要你带走的不是这几个字段,而是那个内核:把你脑子里默认的要求拆开、一条条显性地写出来。结构对了,再谈精进。
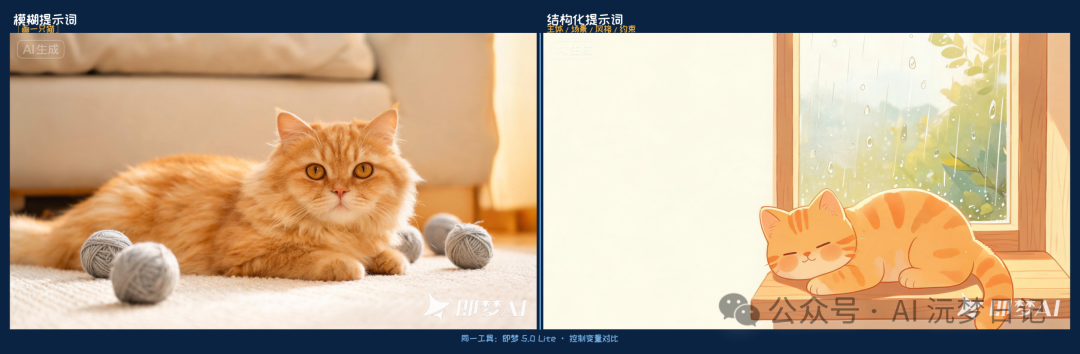
同样是抽卡,模糊提示词像十连里硬赌一个 SSR;结构化提示词是先把保底拉满,再去抽。出货率到不了 100%,但肉眼可见地高。
一句话:结构化提示词不保证出货,但它决定了你出货率的下限。
三、判断出没出货:把“满意”拆成能打分的维度(这就是 Eval)
出货率提上来了,下一个问题来了:怎么算出货?
“我觉得还行”是不够的。凭感觉判断有三个毛病:今天和明天的标准会飘、没法分给别人做、更没法交给机器。要想稳定、要想规模化,你得先把“满意”这件主观的事,拆成几条客观、能逐项检查的维度。
这就是 Eval(内容质量评估)。但要先破除一个误会:Eval 没有一张放之四海皆准的通用清单。评什么,是从你的目标倒推出来的。
有个通用骨架,大多数生成都逃不过这几条:
- 文本 :有没有跑题、是不是一本正经地胡说(事实错误/幻觉)、语气风格对不对、啰不啰嗦重不重复。
- 图片 :图和文对不对得上、画面有没有崩(畸形手、多肢体)、内容得不得体。
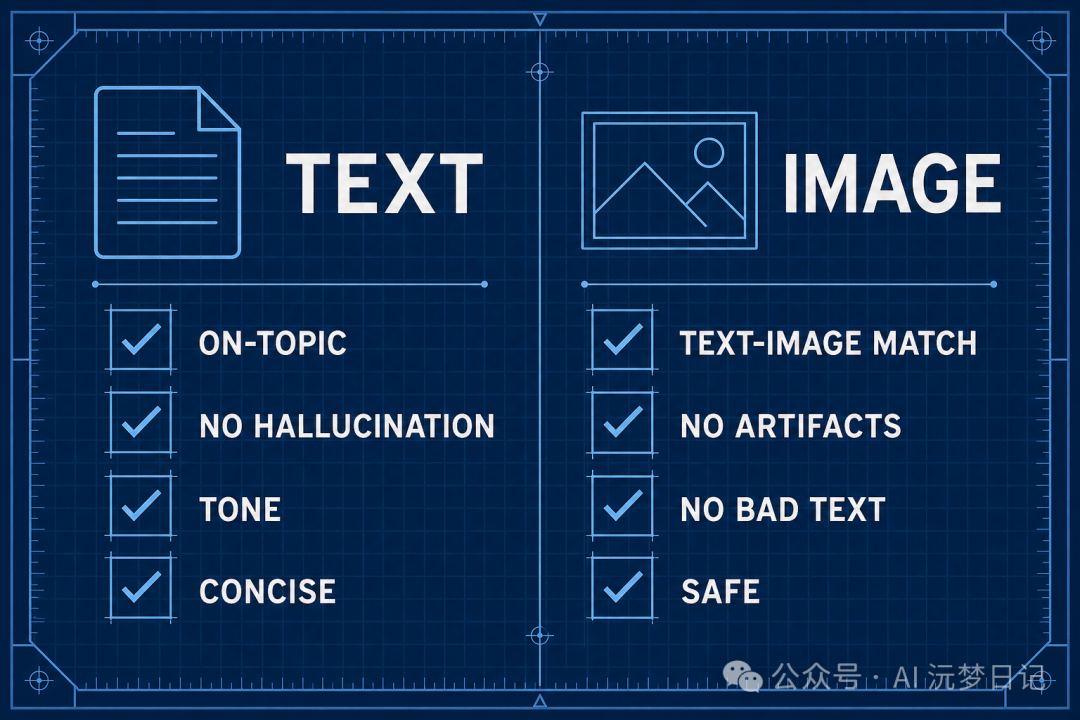
但真正决定成败的,往往是你场景特有的那几条。举个例子:我做中文学习卡片时,会多一条铁律——超纲:句子里不能冒出学生还没学过的字词。这条对写小说、写文案毫无意义,但对教学是生死线。所以别背别人的清单,问自己一句“我这个场景,什么样算不合格”,把答案逐条写下来,那就是你的 Eval。
更进一步,这些维度大多可以让 AI 帮你打分——丢给多模态模型一张图、一句话,问它“这俩对得上吗,1 到 5 分”。但这有个常被忽略的坑:裁判本身也会抽卡。同一张图,它一会儿打 5 分一会儿打 3 分,评估就成了第二个随机源。让裁判稳下来的几个常识动作:把随机性调到最低、强制它按固定格式给结论、出错就自动重试。
四、没出货怎么办?“重抽”是最轻的修复
没出货,大多数人的第一反应是再抽一发。这没错,重抽是最省事的一招——但它也是最轻的一招:如果问题出在提示词本身,你抽一百次,崩的地方还是崩。
真实的修复不止“重抽”一种,关键是对症下药——而开哪种药,正是 Eval 告诉你的“问题出在哪”:
三种方式 · 对症下药
- 原样重抽:画面整体没毛病,纯粹这一抽手气差——换个种子再来一发。
- 改这张的提示词再抽:Eval 指出图文对不上、或数量画错了——针对性补一句约束,再抽。最常用、也最有效。
- 局部重绘:九成画面都好,只有脸或手崩了——只圈出那一块重绘,保住其余,比整张重来划算。
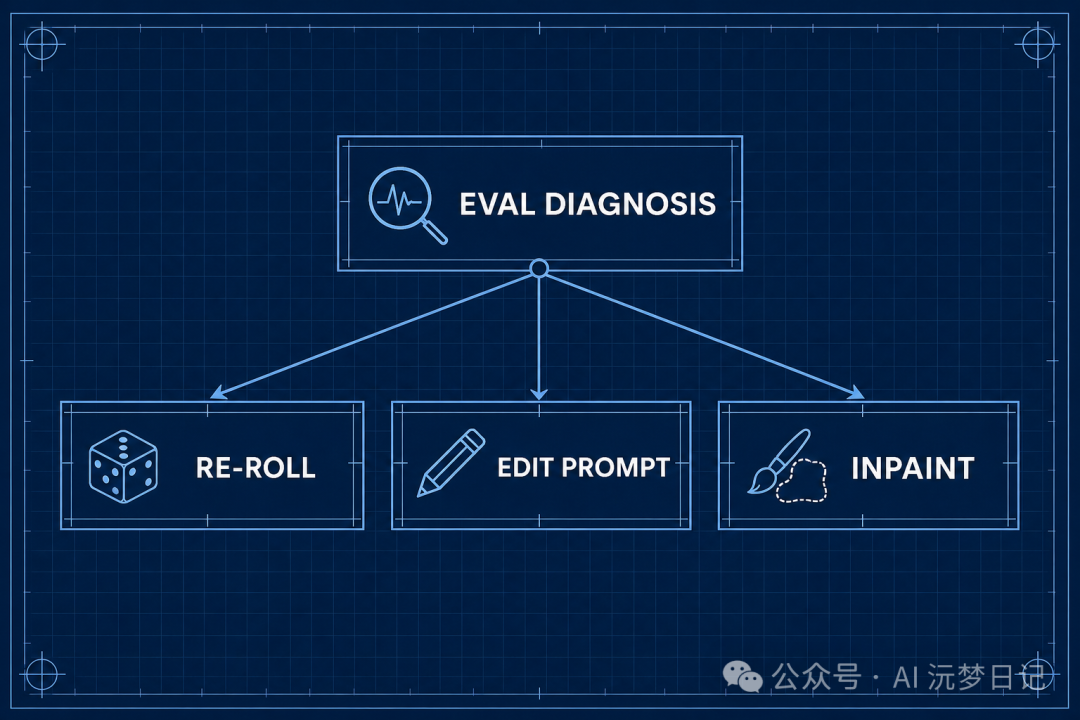
你看,Eval 的价值远不止“过 / 不过”这个开关。一个只会吐 pass/fail 的评估没多大用;能告诉你“是图文不一致,还是手崩了”的评估,才能驱动你选对修复动作。先诊断,再下药,比闷头重抽高效得多。
把这几种手段接起来,就是完整的图文闭环:结构化提示词抽卡 → Eval 诊断 → 按问题选择重抽 / 改词 / 局部重绘 → 再评一次。它把生成从“祈祷一次成型”,变成了一个 允许失败、且让失败廉价可控 的过程。
让闭环不累人的关键是:人在环,但人只看灰色地带。明显达标和明显报废的交给 Eval 筛掉,人只裁决“也许行也许不行”的那些。
那再往前一步呢?上面“改这张的提示词”是针对单张、人工在做的。理想态是把它系统化:让 Eval 从成百上千次结果里自动总结出共性问题,回流去改进模板提示词,让整体出货率越滚越高。说实话这一步很难,我目前也还是人工在做——但哪怕只做到“诊断 + 对症修复”这一层,你已经甩开“凭感觉抽卡”一大截了。
五、当标准固定下来,规模化是水到渠成
走到这你会发现一件有意思的事:一旦“什么叫达标”被拆成了清清楚楚的维度,量就不再是问题。
因为抽卡可以批量抽、Eval 可以批量打分、不达标的可以批量重来——人只在最后看一眼那份“哪些过了、哪些得返工”的清单。我自己就是这样把几百张中文学习卡片的图文做下来的:靠的不是手快,而是标准固定后,重复劳动可以交出去。
但请记住,规模化只是结果,不是门槛。这套“抽卡—诊断—修复”的思路,你哪怕只做 5 张图也立刻能用。它和量无关,只和你愿不愿意把“满意”想清楚有关。
写在最后
回到最初那个问题:怎么让 AI 稳定产出你满意的图文?
- 承认它是抽卡,别赌一次成型;
- 用 结构化提示词 ,提高每一抽的出货率;
- 用 Eval ,把“满意”拆成能判断的维度;
- 接成 闭环 ,对症修复,人只看灰色地带。
从概念、工具到这一篇的实践,多模态生成真正拉开差距的,从来不是谁的提示词更玄、谁的工具更新,而是谁先把“质量”当成一件能被定义、被测量、被迭代的事。
抽到好卡靠运气,稳定出货靠工作流。